Решения и услуги
Ваши запросы
Посещенные страницы

К сожалению, ничего не найдено.

Попробуйте переформулировать запрос.

LLM (большие языковые модели)

LLM: что такое большие языковые модели, как они работают и как их внедрить в компании

Редакция «КОРУС Консалтинг»
Автор

Исследование «КОРУС Консалтинг» среди более чем 80 компаний показало, что ИИ не используют лишь 8% респондентов, но подтвердить реальный бизнес-эффект могут 12%, а у 47% нет внутренних правил работы с ИИ. Почти за каждым таким проектом стоит большая языковая модель, и разрыв между «попробовали» и «заработали» часто начинается с непонимания того, что она умеет, а что нет.

LLM (Large Language Model, большая языковая модель) — это нейросеть, обученная на огромных массивах текстов предсказывать следующий фрагмент текста. Из этой простой задачи вырастают умения, которыми пользуется бизнес: отвечать на вопросы, писать и сокращать тексты, переводить, извлекать данные из документов, писать код. Большой модель называют из-за числа параметров — настраиваемых весов нейросети. Их счёт идёт на миллиарды, и российский закон об ИИ проводит границу именно по этому признаку (об этом ниже).

Статья основана на практике группы «КОРУС Консалтинг»: команды ИИ-решений, продуктовой команды «Авандок» и компании «ДАР», которые разворачивают языковые модели в контуре заказчиков.

Что такое LLM простыми словами

Представьте автодополнение в телефоне, которое прочитало большую часть открытого интернета, книги, документацию и код. Оно уже не подсказывает одно слово, а продолжает мысль абзацами, удерживает контекст длинного документа и меняет стиль по просьбе. Так и работает LLM: модель не ищет ответ в базе, а генерирует его, раз за разом выбирая наиболее подходящее продолжение.

Отсюда главное свойство, о котором стоит помнить руководителю: языковая модель выдаёт правдоподобный текст, а не гарантированно верный. Если в обучающих данных не было нужного факта, модель всё равно ответит, причём уверенно. Такие ошибки называют галлюцинациями.

Термин «LLM» часто используют как синоним слова «нейросеть», но это не одно и то же. Нейросети распознают лица, прогнозируют спрос, находят дефекты на конвейере. LLM — только один их класс, который работает с языком. ChatGPT, GigaChat, YandexGPT, Claude — продукты, внутри которых работают большие языковые модели.

Как работают большие языковые модели

alt=
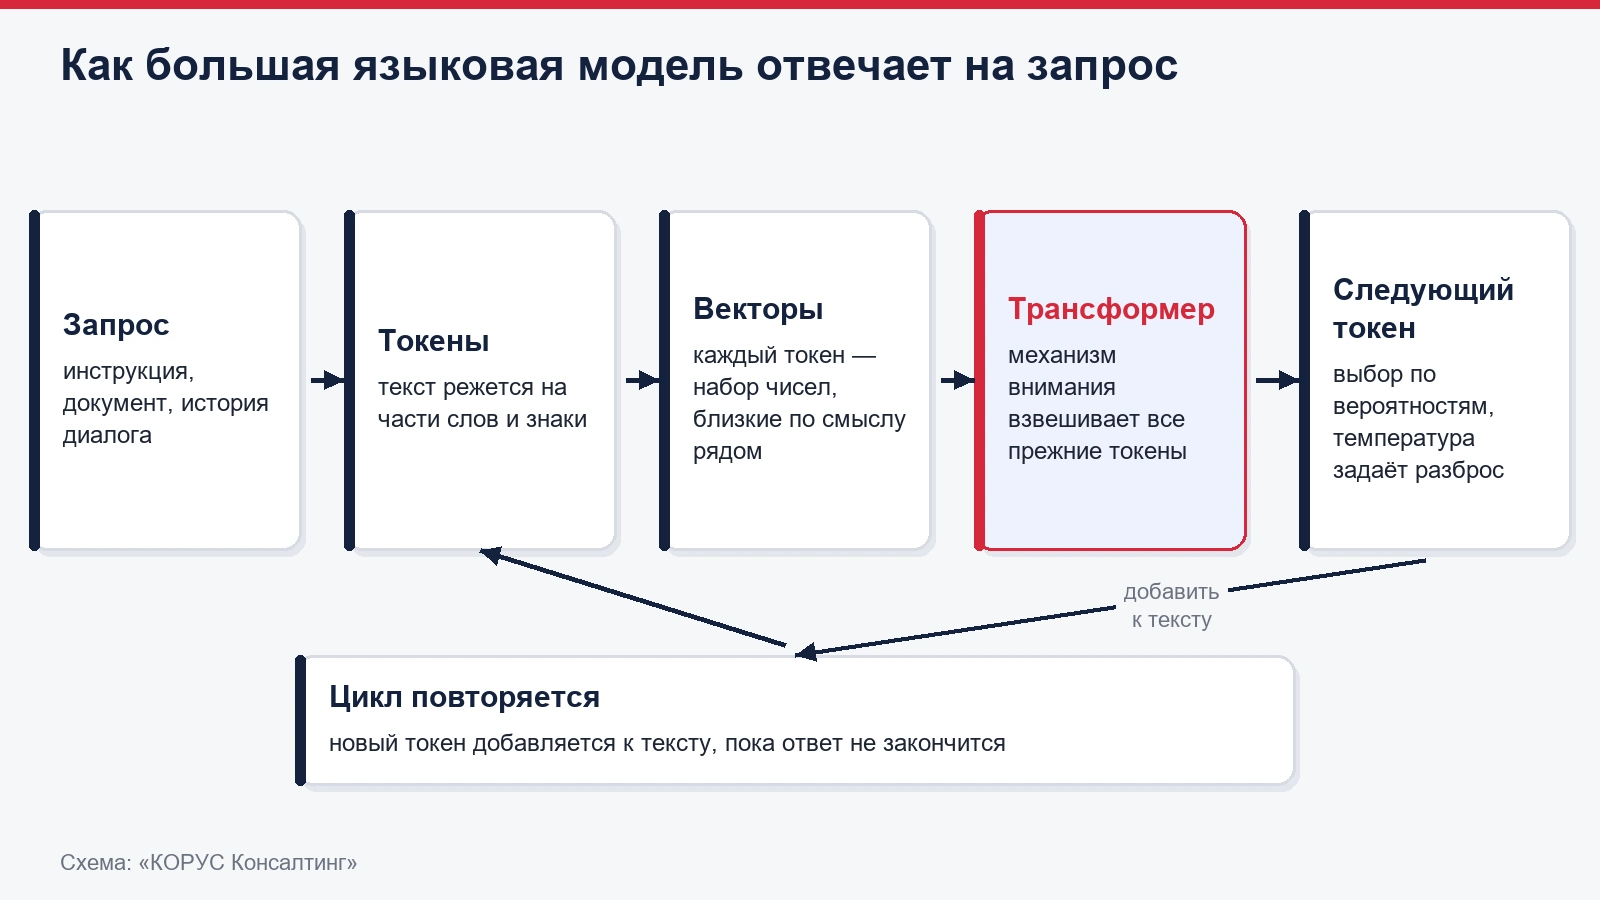
Как LLM превращает запрос в ответ: от токенов до следующего слова

Токены

Модель не видит слова целиком. Текст режется на токены — части слов, слова или знаки. Русский текст обычно дробится сильнее английского, поэтому один и тот же запрос на русском у многих моделей «весит» больше токенов. Бюджет это чувствует: облачные модели тарифицируют именно токены.

Векторы

Каждый токен превращается в набор чисел — вектор. Близкие по смыслу слова получают близкие векторы, и модель оперирует уже смыслом, а не буквами.

Трансформер

Почти все современные LLM построены на архитектуре Transformer, которую описали исследователи Google в статье «Attention Is All You Need» в 2017 году (arXiv:1706.03762). Её основа — механизм внимания: при расчёте каждого следующего токена модель «смотрит» на все предыдущие и решает, какие из них сейчас важнее. Поэтому она понимает, к чему относится «он» через три предложения.

Предсказание следующего токена

На выходе модель получает распределение вероятностей и выбирает очередной токен. Затем добавляет его к тексту и повторяет цикл, пока ответ не закончится. Параметр «температура» управляет разбросом: при низкой ответы стабильнее, при высокой разнообразнее.

Контекстное окно

Это объём текста, который модель держит в голове за один запрос: инструкция, документ, история диалога. Всё, что не поместилось, модель не учитывает.

Как обучают языковую модель

Обучение идёт в несколько стадий:

  1. Предобучение. Модель прогоняют через триллионы токенов текста, и она учится предсказывать продолжение. Стадия стоит дороже всего: нужны тысячи GPU и месяцы работы, поэтому базовые модели создают единицы компаний.
  2. Дообучение на инструкциях. Модели показывают примеры «вопрос — хороший ответ», и она учится выполнять просьбы, а не просто продолжать текст.
  3. Настройка по оценкам людей. Люди сравнивают ответы, и модель подстраивают под предпочтения: вежливость, отказ от опасных тем, формат ответа.

Компании, которые внедряют LLM, почти никогда не обучают модель с нуля. Они берут готовую и адаптируют её под себя одним из трёх способов, о которых ниже.

Зачем LLM бизнесу

Языковые модели закрывают задачи, где раньше нужен был человек, потому что данные были в тексте, а не в таблицах.

  • Поиск по корпоративным знаниям. Сотрудник спрашивает своими словами «как согласовать договор с контрагентом из ЕАЭС» и получает ответ со ссылкой на регламент.
  • Работа с документами. Классификация входящих писем, извлечение сумм, дат и контрагентов, проверка договора на рискованные формулировки.
  • Клиентский сервис. Ассистенты в чате и подсказки оператору, которые знают каталог и историю обращений.
  • Разработка и ИТ. Генерация и ревью кода, документация, ответы на вопросы об устройстве старой системы.
  • Данные. Описание метаданных, генерация SQL-запросов, пояснения к отчётам. Команда «ДАР» разбирала, как LLM помогает описывать метаданные в дата-каталоге с опорой на бизнес-глоссарий.

Где LLM пока лучше не ставить без человека: решения с юридическими или финансовыми последствиями, расчёты, точные цифры. Алексей Борщов, который в КОРУС Консалтинг отвечает за ИИ-продукты экосистемы «Авандок», сформулировал это в комментарии CNews: «ИИ пока не автопилот, а второй пилот: он помогает, подсказывает, но окончательное решение принимает человек».

Материал оказался полезным?
Оставьте почту и мы пришлем его в формате .pdf
Получить  материал Материал оказался полезным? Материал оказался полезным?
ИИ-трансформация бизнеса, результат которой измеряется в деньгах. Подробнее... ИИ-трансформация бизнеса, результат которой измеряется в деньгах.

Виды LLM

По доступу. Облачные модели работают через API у поставщика: быстро начать, платишь за токены, данные уходят за периметр. Открытые модели (open source или open weights) можно скачать и развернуть на своих серверах: данные остаются внутри, зато инфраструктура и поддержка на вас.

По размеру. Крупные универсальные модели берутся за любую задачу, от письма клиенту до разбора кода, но требуют дорогого железа или ощутимого счёта за токены. Малые языковые модели на единицы миллиардов параметров дешевле в работе и после дообучения часто справляются с узкой задачей не хуже. Если компания разворачивает локальную LLM под один-два сценария, мы обычно начинаем сравнение именно с малых моделей: переплачивать за универсальность, которой никто не пользуется, нет смысла.

По модальности. Мультимодальные модели, помимо текста, принимают сканы, фото и аудио.

По специализации. Универсальные, модели для кода, отраслевые.

LLM, RAG, дообучение и ИИ-агенты: в чём разница

Эти понятия путают чаще всего, хотя они отвечают на разные вопросы. LLM — сам «мозг». Остальное — способы заставить его работать с вашими данными и системами.

alt=
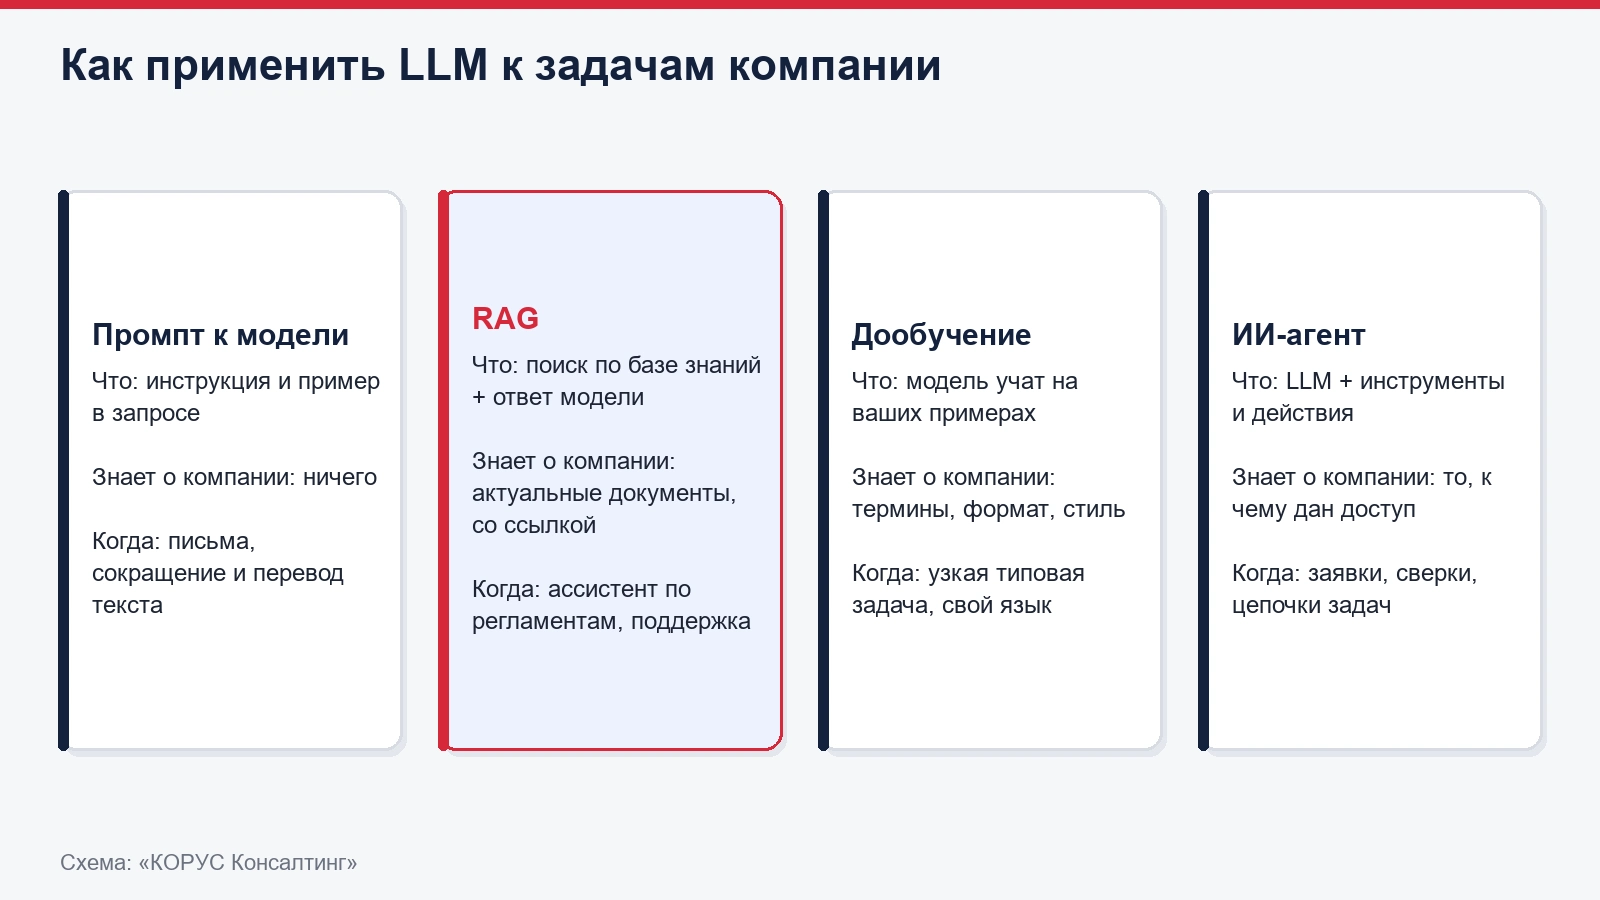
Базовая модель, RAG, дообучение и ИИ-агент: что выбрать под задачу

  • Промпт к базовой модели. Инструкция и пример в запросе. Подходит для общих задач — написать письмо, сократить текст. О вашей компании модель ничего не знает.
  • RAG (Retrieval-Augmented Generation). Перед ответом система находит подходящие фрагменты в базе знаний компании и передаёт их модели вместе с вопросом. Ответ опирается на актуальные документы и содержит ссылку на источник. Это самый частый способ получить корпоративного ассистента, подробно он разобран в статье что такое RAG.
  • Дообучение (fine-tuning). Модель дополнительно обучают на ваших примерах. Так она осваивает терминологию, формат ответа, стиль. Новые факты лучше подавать через RAG: дообученную модель приходится переобучать при каждом изменении регламента.
  • ИИ-агент. LLM, которой дали инструменты: доступ к CRM, почте, базе данных, возможность выполнять действия цепочкой. Агент уже действует: создаёт заявку, сверяет данные, передаёт задачу другому агенту. Виды агентов и сценарии — в материале о том, как ИИ-агенты меняют работу бизнеса.

На практике эти слои складывают. Типичный корпоративный ассистент — это LLM плюс RAG по базе знаний, иногда с лёгким дообучением под формат и с парой инструментов для действий.

Языковые модели в России: решения и закон

Российские компании выбирают из трёх групп:

  • отечественные облачные модели — GigaChat от Сбера, YandexGPT от Яндекса, доступные через API и в облачных платформах;
  • открытые модели мировых и российских разработчиков, которые разворачивают на своих серверах; о рисках и плюсах одной из них КОРУС Консалтинг писал в материале как DeepSeek повлияет на российский бизнес;
  • зарубежные облачные сервисы — для компаний, у которых нет ограничений по данным; для большинства крупных заказчиков этот вариант закрыт требованиями безопасности.

С 1 сентября 2026 года действует Федеральный закон № 243-ФЗ «О поддержке развития технологий искусственного интеллекта в Российской Федерации» (официальная публикация). В статье 3 он вводит понятие большой фундаментальной модели ИИ: программа, которая решает широкий круг интеллектуальных задач и содержит не менее 1 миллиарда параметров. Закон устанавливает статусы суверенной и национальной модели. Обязанности разработчиков, требования к статусам и правила использования произведений при обучении вступают в силу с 1 марта 2027 года.

Для заказчика вывод практический. Организациям критической инфраструктуры не привязываться к одной языковой модели или поставщику и строить модульную архитектуру. Заложите возможность сменить модель без переписывания ассистента. Модели обновляются каждые несколько месяцев, и сегодняшний лидер через год может уступить по цене или качеству.

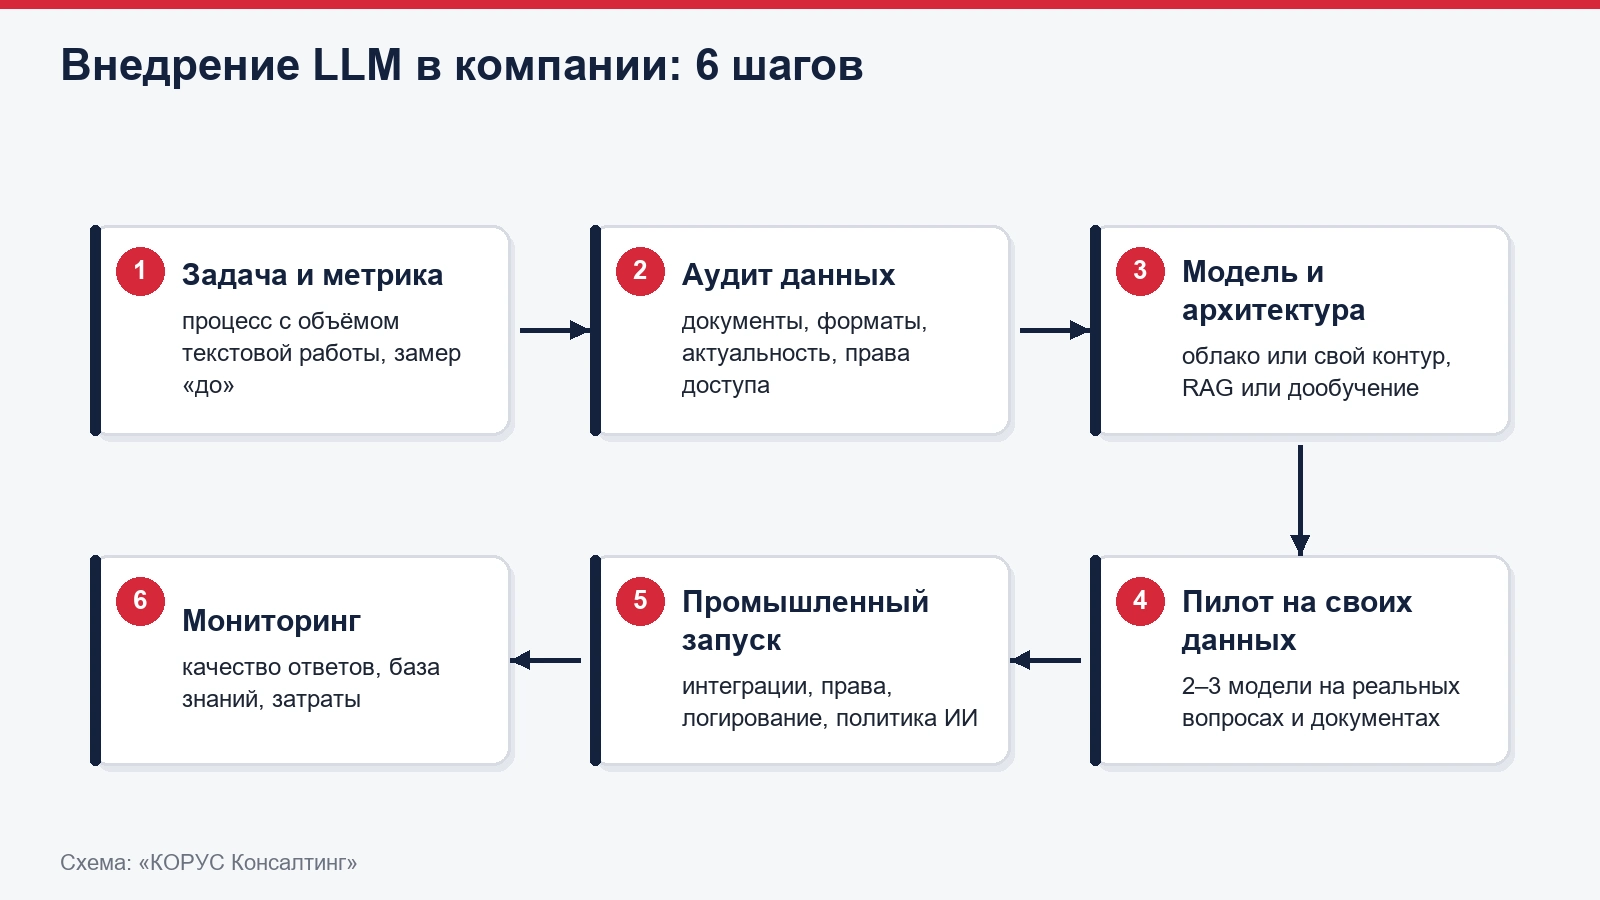
Как выбрать и внедрить LLM в компании

Внедрение LLM: шесть шагов от гипотезы до промышленной эксплуатации

  1. Задача и метрика. Начните с процесса, где много однотипной текстовой работы и понятен эффект: время ответа поддержки, часы юристов на проверку договоров, доля документов, разобранных без человека.
  2. Аудит данных. Какие документы есть, в каком формате, насколько они актуальны, кто имеет к ним доступ. Ассистент повторит хаос базы знаний, а не исправит его.
  3. Модель и архитектура. Облако или свой контур, крупная модель или малая, RAG или дообучение. Критерии: требования к данным (152-ФЗ, коммерческая тайна), качество на русском и на вашей лексике, стоимость токена или GPU-часа, лицензия.
  4. Пилот на своих данных. Сравните две-три модели на одном наборе реальных вопросов и документов. Публичные рейтинги моделей мало говорят о том, как они справятся с вашими регламентами.
  5. Промышленный запуск. Интеграция с корпоративными системами и правами доступа, логирование запросов, политика использования ИИ для сотрудников.6. Мониторинг и развитие. Регулярная оценка качества ответов, обновление базы знаний, учёт затрат.

Про деньги отдельно. Стоимость складывается из лицензий или токенов, инфраструктуры, работ по данным и поддержки, и последние две статьи обычно недооценивают. Как посчитать бюджет и эффект, разобрано в статье о том, сколько стоит разработка и внедрение ИИ.

Сложности LLM в крупной компании

Безопасность данных. Облачные модели принимают данные на чужих серверах, и для банков, промышленности и госсектора это часто неприемлемо. Ещё одна проблема — теневой ИИ: сотрудники отправляют документы в публичные чат-боты в обход ИТ. Запрет без альтернативы не работает. Нужен корпоративный инструмент и контроль утечек, например средствами DLP-систем.

Стоимость инфраструктуры. Локальная LLM требует GPU-серверов. По словам Алексея Борщова, их стоимость может достигать десятков миллионов рублей. Поэтому команды уменьшают модели и ищут баланс между размером, точностью и скоростью.

«Зоопарк» документов. Сканы, рукописные бланки, таблицы внутри PDF. Прежде чем LLM ответит по документу, его нужно распознать и правильно нарезать на фрагменты.

Права доступа. Ассистент не должен пересказывать сотруднику документ, который тот не вправе открыть. Разграничение прав нужно переносить в поисковый слой, а не надеяться на модель.

Оценка эффекта. По данным исследования КОРУС Консалтинг, 44% компаний вообще не измеряют эффект от ИИ, ещё 25% отслеживают отдельные показатели без связи с экономикой. Без базовой линии «до» пилот невозможно защитить перед финансовым директором.

Частые ошибки

  • Ждать от LLM точности базы данных. Модель генерирует текст. Цифры, даты и номера договоров должны приходить из систем, а не из «памяти» модели.
  • Выбирать модель по рейтингу. Победитель общего бенчмарка может проиграть малой дообученной модели на ваших документах.
  • Начинать с самого сложного процесса. Первый проект на критичной для бизнеса задаче с высокой ценой ошибки чаще всего застревает в согласованиях.
  • Дообучать там, где нужен RAG. Регламенты меняются, а переобучение стоит денег и времени.
  • Не планировать поддержку. Через полгода база знаний устаревает, появляются новые типы документов, качество ответов падает, и пользователи уходят.
  • Сто разрозненных пилотов. По данным КОРУС Консалтинг, единую масштабируемую ИИ-платформу развивают лишь 13% организаций, а 45% используют отдельные облачные сервисы под конкретные задачи. Так эффект не складывается.

Как «КОРУС Консалтинг» помогает внедрить LLM

Группа «КОРУС Консалтинг» ведёт проекты с языковыми моделями от стратегии и выбора сценариев до развёртывания в контуре заказчика. Направление ИИ-решений для бизнеса включает консалтинг, стратегические сессии, ассистентов, агентов и умный поиск.

KORUS AI. Корпоративная ИИ-платформа объединяет документы, знания, коммуникации и ИИ-сервисы в одном управляемом контуре. Она подключает разные языковые модели, контролирует права доступа, логирует действия и следит за бюджетами и лимитами. В октябре 2026 года к платформе добавился модуль «Навигатор систем»: цепочка ИИ-агентов отвечает на вопросы об устройстве корпоративной системы, проектирует доработки, оценивает трудозатраты и проводит ревью кода. Агенты подключаются к системе через MCP-сервер, для чувствительных данных предусмотрены анонимизация и локальные модели. Есть коннекторы для конфигураций 1С, Microsoft Dynamics AX и NAV.

Авандок ИИ. В платформе «Авандок» работает интеллектуальный помощник для баз знаний и нормативной документации. Он отвечает на естественном языке со ссылками на документы-источники и построен на локальных генеративных моделях внутри контура организации. Сама платформа получила сертификат ФСТЭК. Как устроен такой помощник и почему его разворачивают локально, разобрано в статье о корпоративном ИИ-эксперте без утечек данных.

Nextera. В 2026 году КОРУС Консалтинг приобрёл 33,3% разработчика платформы Nextera для управления командами ИИ-агентов. Платформа разворачивается в инфраструктуре заказчика, а агенты-разработчики, аналитики и тестировщики работают под контролем человека.

Примеры кейсов

«Подружка». Компания «ДАР» создала для сети магазинов косметики ИИ-помощника в Telegram, который ведёт диалог с покупателем и подбирает товары. В основе — open source разработка с внешней коммерческой LLM. Архитектура позволяет менять или донастраивать модель без переделки решения, то есть ровно тот принцип модульности, о котором шла речь выше.

Если вы выбираете между облачной и локальной моделью, ищете первый сценарий или хотите собрать разрозненные пилоты в одну платформу, обсудите задачу с командой ИИ-решений. Обычно работа начинается со стратегической сессии и пилота на данных заказчика.

Заключение

Большая языковая модель — инструмент для работы с текстом, а не источник истины. Ценность для компании появляется, когда модель получает доступ к проверенным корпоративным данным, встроена в процесс с понятной метрикой и работает под контролем по правам и безопасности. Сама модель в этой конструкции самая заменяемая часть, и проектировать её стоит именно так.

Если вы только начинаете, возьмите один процесс с большим объёмом однотипных документов, измерьте его до пилота и сравните две-три модели на своих данных. А если пилотов уже много, а эффекта нет, пора переходить к платформе. Команда «КОРУС Консалтинг» поможет на любом из этих шагов.

Частые вопросы

Что такое LLM простыми словами?

LLM (Large Language Model) — большая языковая модель, нейросеть, которая обучена на огромном объёме текстов и умеет продолжать текст. Благодаря этому она отвечает на вопросы, пишет, переводит и анализирует документы.

Чем LLM отличается от нейросети?

LLM — один из видов нейросетей, тот, что работает с языком. Нейросети бывают и другие: для распознавания изображений, прогнозов, анализа сигналов.

Можно ли развернуть LLM локально?

Да. Открытые модели разворачивают на собственных серверах компании, и данные не покидают периметр. Понадобятся GPU-серверы и команда поддержки, а для экономии часто берут малые модели и дообучают их под задачу.

Почему LLM ошибается?

Модель предсказывает правдоподобный текст, а не проверяет факты. Если нужной информации не было в обучении или в переданном контексте, она может сочинить ответ. Снижают риск RAG со ссылками на источники и проверка человеком в критичных процессах.

Чем RAG отличается от дообучения модели?

RAG подставляет в запрос актуальные фрагменты из базы знаний, и модель отвечает по ним. Дообучение меняет саму модель: учит терминологии и формату. Факты, которые часто меняются, лучше давать через RAG.

Может ли КОРУС Консалтинг помочь внедрить LLM в компании?

Да. «КОРУС Консалтинг» проводит стратегические сессии по ИИ, помогает выбрать модель и архитектуру, разворачивает корпоративную платформу KORUS AI и ассистентов в контуре заказчика, а компания «ДАР» создаёт ИИ-помощников на основе LLM для клиентских каналов.


Источники

  1. «КОРУС Консалтинг». Исследование: почти 70% компаний не могут оценить эффект от внедрения ИИ, 02.09.2026 — https://korusconsulting.ru/press-centr/issledovanie-korus-konsalting-pochti-70-kompaniy-ne-mogut-otsenit-effekt-ot-vnedreniya-ii/
  2. Vaswani A. et al. Attention Is All You Need, 2017 — https://arxiv.org/abs/1706.03762
  3. Федеральный закон от 26.07.2026 № 243-ФЗ «О поддержке развития технологий искусственного интеллекта в Российской Федерации», официальная публикация — http://publication.pravo.gov.ru/document/0001202607260003
  4. CNews / «КОРУС Консалтинг». Алексей Борщов: «На текущем уровне развития ИИ все бизнес-процессы должны контролировать люди», 02.12.2025 — https://korusconsulting.ru/press-centr/aleksey-borshchov-korus-konsalting-na-tekushchem-urovne-razvitiya-ii-vse-biznes-protsessy-dolzhny-ko/

Заявка отправлена
Заявка отправлена

Спасибо за заявку! Мы рассмотрим ее в ближайшее время и обязательно свяжемся с вами по телефону или email.

Документ отправлен
Заявка отправлена

Документ уже отправлен на вашу почту,
 и вы сможете ознакомиться с ним в удобное для вас время.

Запрос отправлен
Заявка отправлена

Ваш запрос на материалы мероприятия отправлен.

Попап с тегом, датой и кнопкой  - исследование ИИ - медиацентр
исследование
Исследование применения ИИ в российском бизнесе 2026: барьеры внедрения, зрелость стратегии, оценка инвестиций.